Como um Rig de mineração de US$35 está rodando um modelo de IA de 35 bilhões de parâmetros no Brasil
Um entusiasta transformou um antigo equipamento de mineração em um servidor de IA, provando que a democratização dos modelos grandes pode começar por garagens e peças usadas
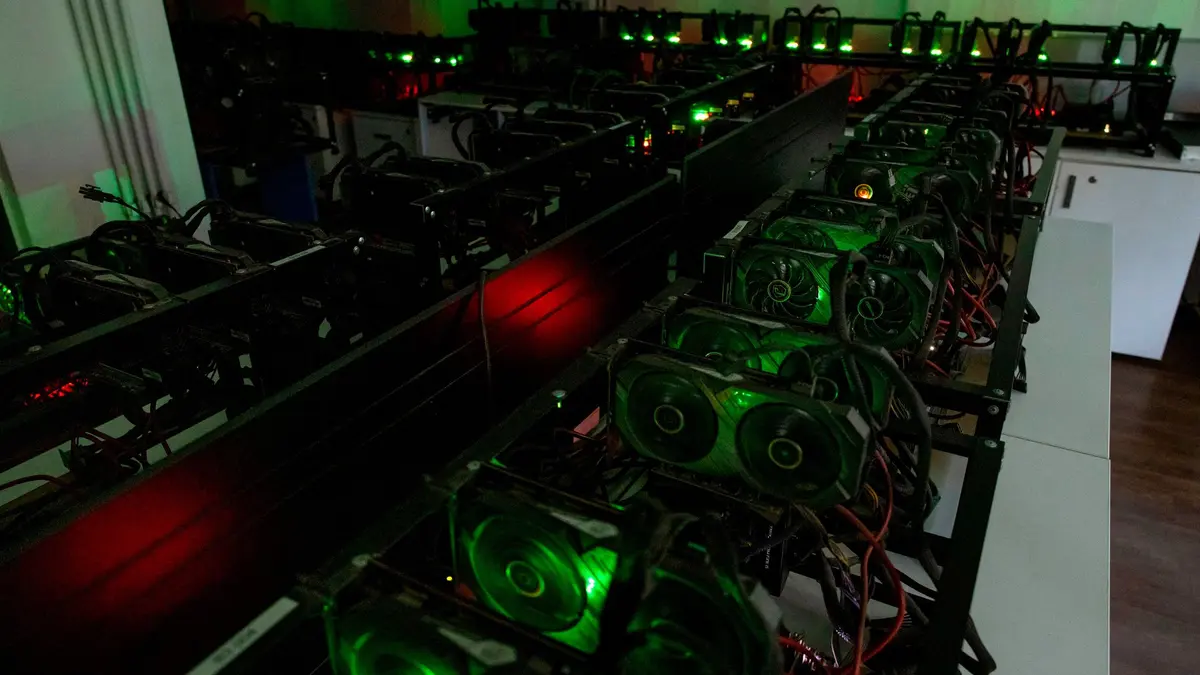
A corrida por inteligência artificial generativa tem sido dominada nos últimos anos por gigantes da tecnologia que investem bilhões em data‑centers equipados com GPUs de última geração. Contudo, uma história curiosa que circulou no Reddit nos últimos dias mostra que, em algumas circunstâncias, a fronteira entre o impossível e o acessível pode ser atravessada em garagens de bairro. Um usuário anônimo comprou, em um leilão online, um rig de mineração de criptomoedas — nove placas Nvidia P106‑100, originalmente projetadas para extrair Ethereum, mas descartadas quando a rede migrou para o algoritmo proof‑of‑stake. O preço? Apenas US$35, equivalente a cerca de R$180 na cotação atual. O total de memória de vídeo desses chips soma 54 GB, o que o comprador descreveu como “54 GB de VRAM a 65 centavos por gigabyte”.
Ao adquirir o equipamento, o usuário não pretendia retomar a mineração. Em vez disso, ele o transformou em um servidor de inferência de modelo de linguagem. A escolha recaiu sobre o Qwen 3.6‑35B‑A3B, um modelo de 35 bilhões de parâmetros desenvolvido pela Alibaba Cloud, que combina instruções avançadas e capacidade de raciocínio em linguagem natural. O ponto crucial é que, embora o modelo seja grande, ele pode ser dividido em partes menores que cabem em GPUs com memória limitada, usando técnicas de quantização de 4‑bits e paralelização de tensor. O resultado: o modelo roda localmente, sem a necessidade de conexão com a nuvem, em tempo real, e com latência aceitável para experimentos de pesquisa e prototipagem.
### O que são as GPUs P106‑100?
As placas Nvidia P106‑100 são variantes de baixo custo da série GTX 1060, lançadas em 2016. Elas foram otimizadas para mineração, removendo as saídas de vídeo e reduzindo o consumo energético, mas mantendo a mesma arquitetura Pascal de 6 GB de GDDR5 por chip. Cada unidade oferece cerca de 1 300 GFLOPS em ponto flutuante de 32 bits, desempenho suficiente para cálculos de hash, mas considerado modesto frente às GPUs RTX 40‑series, que chegam a 10 TFLOPS em FP16. O que torna o P106‑100 ainda atrativo hoje é a disponibilidade massiva de unidades usadas, ainda em bom estado, e o preço de sucata, que pode ser negociado em leilões, mercados de segunda‑mão e até mesmo em sites de leilão de ativos de mineração.
### Por que 54 GB de VRAM custam tão pouco?
O cálculo apresentado pelo Redditor — US$35 por 54 GB, ou US$0,65 por GB — revela a diferença drástica entre a memória de vídeo usada em servidores de IA de alto nível (onde 80 GB HBM2X podem custar US$5.000 por placa) e o estoque de memória de GPUs antigas. A memória GDDR5 da era Pascal, ainda produzida em larga escala para consoles e PCs de médio porte, tem preço de mercado próximo ao de chips de memória DDR4. Quando combinada em um conjunto de nove placas, a relação custo‑benefício se volta a favor de quem está disposto a montar um cluster caseiro.
### Técnicas de otimização que tornam o impossível viável
Rodar um modelo de 35 b de parâmetros em GPUs de 6 GB requer estratégias avançadas. A primeira delas é a quantização, que reduz a precisão dos pesos de 16‑bits ou 32‑bits para 4‑bits, diminuindo drasticamente o uso de memória sem perder muita acurácia — um trade‑off estudado por pesquisadores da OpenAI e da Meta. Em seguida, há a divisão de camadas (model parallelism), que distribui partes diferentes da rede neural entre várias GPUs, sincronizando os gradientes apenas quando necessário. Ferramentas como DeepSpeed, FSDP (Fully Sharded Data Parallel) e TensorRT‑LLM da Nvidia facilitam esse processo, permitindo que o usuário configure scripts que automaticamente “shard” (fragmentam) o modelo.
### Implicações para a democratização da IA
Esse experimento tem implicações profundas para a democratização da IA. Primeiro, demonstra que a barreira de entrada para pesquisadores independentes, startups e entusiastas no Brasil e na América Latina pode ser muito mais baixa do que se imagina. Em vez de depender de créditos em nuvem — que, para um modelo como Qwen‑35B, podem superar US$10.000 por mês —, basta encontrar hardware usado e aplicar técnicas de quantização. Segundo, ao rodar o modelo localmente, elimina‑se a dependência de provedores de nuvem estrangeiros, reduzindo custos de transferência de dados e mitigando preocupações de soberania de dados, tema sensível no contexto brasileiro de LGPD (Lei Geral de Proteção de Dados).
### Desafios práticos e limitações
Entretanto, o caminho não é livre de obstáculos. O consumo energético de nove GPUs P106‑100, embora menor que o de rigs modernos, ainda pode ultrapassar 1,2 kW, exigindo fontes de alimentação robustas e um sistema de refrigeração adequado. A falta de saídas de vídeo nas placas também implica que o usuário precise de um “headless” setup, com acesso remoto via SSH ou VNC. Outro ponto crítico é a estabilidade do software: a integração de bibliotecas de quantização e paralelismo nem sempre é trivial, exigindo conhecimento avançado de Linux, drivers Nvidia e ambientes de desenvolvimento Python.
### O mercado brasileiro e a oportunidade de reaproveitamento
No Brasil, a explosão do mercado de mineração de criptomoedas entre 2020 e 2022 gerou uma enxurrada de equipamentos que, com a mudança para proof‑of‑stake, foram abandonados ou vendidos a preços de banana. Muitas dessas unidades ainda se encontram em armazéns de data‑centers, universidades ou até em garagens de pequenos empreendedores. Um estudo da ABES (Associação Brasileira das Empresas de Software) estima que cerca de 15 % dos rigs de mineração instalados no país estejam ociosos. Essa reserva de hardware pode ser a base para um ecossistema de IA descentralizada, onde laboratórios universitários, incubadoras de startups e até prefeituras podem montar servidores de inferência para serviços públicos — como análise de documentos, chatbots de atendimento ou monitoramento de infrações.
### Impacto econômico e geopolítico
Ao reduzir a dependência de provedores de nuvem estrangeiros, países emergentes podem preservar mais receita em divisas e estimular o desenvolvimento de talentos locais. Além disso, a produção de soluções de IA localizadas pode gerar novos nichos de mercado, como consultorias de otimização de modelos, manutenção de clusters de GPUs usadas e treinamento de equipes em técnicas de quantização. No cenário geopolítico, a capacidade de rodar grandes modelos sem depender de infraestruturas externas pode ser vista como um elemento de soberania tecnológica, alinhado às estratégias de países como Índia e Rússia, que investem em computação nacional.
### Perspectiva de futuro: para onde vai a IA de “garagem”?
O caso do Redditor pode ser visto como um protótipo de um movimento maior: a chamada "AI on the Edge" — IA nas bordas da rede, mas não no sentido de dispositivos móveis, e sim em ambientes de baixo custo e alta acessibilidade. À medida que bibliotecas de quantização evoluem e surgem novos modelos otimizados para hardware limitado (por exemplo, LLaMA‑7B‑Quant), a necessidade de GPUs de última geração pode diminuir. Paralelamente, projetos como o OpenCompute da Meta e o OpenAI Hardware Transparency Initiative podem incentivar a produção de designs de hardware modular, facilitando a montagem de rigs com componentes reutilizados.
Para o Brasil, a convergência entre a disponibilidade de rigs usados, a expertise crescente em ciência de dados e a pressão por soluções de IA mais econômicas cria um caldo fértil para startups que ofereçam serviços de inferência local. Imagine uma fintech que, ao invés de pagar centenas de milhares de dólares em créditos de nuvem, roda seu modelo de risco de crédito em um cluster de P106‑100, reduzindo custos operacionais e aumentando a rapidez de decisões.
### Conclusão
A história do rig de US$35 que roda um modelo de 35 b de parâmetros ilustra que, quando combinamos criatividade, técnicas avançadas de compressão e um mercado saturado de hardware usado, as fronteiras da IA podem ser redimensionadas. No Brasil e na América Latina, onde o custo de infraestrutura em nuvem ainda é um freio significativo para inovação, a reutilização de equipamentos de mineração pode abrir caminhos inéditos para pesquisa, empreendedorismo e serviços públicos. O desafio permanece em transformar esses experimentos pontuais em ecossistemas sustentáveis, com suporte técnico, energia renovável e regulamentação que favoreça a soberania dos dados. Se a comunidade de desenvolvedores, universidades e governos conseguir articular esses elementos, a próxima revolução da IA pode muito bem nascer nas garagens de cidades como São Paulo, Buenos Aires ou Medellín, e não nos data‑centers de Silicon Valley.
Fonte original
Tom's Hardware