GRASP: Planejamento de Longo Prazo com Modelos de Mundo
O algoritmo que torna o controle de robôs em ambientes complexos mais eficiente e confiável
O avanço dos modelos de mundo — simulações internas que predizem sequências de observações a partir de ações — transformou a forma como pesquisadores e engenheiros pensam sobre controle e aprendizado em ambientes complexos. Esses modelos, que antes eram vistos como ferramentas de previsão pontual, agora se aproximam de simuladores genéricos capazes de capturar dinâmicas visuais de alta dimensionalidade. Entretanto, usar essas capacidades para planejar sequências de ações de longo prazo permanece um grande desafio: a otimização tende a se tornar mal condicionada, a estrutura não-greedy gera mínimos locais ruins e espaços latentes de alta dimensionalidade introduzem modos de falha sutis. O artigo “Gradient-based planning for world models at longer horizons” apresenta o GRASP (Gradient-based Planning for Longer Horizons), uma solução que torna a otimização de ações robusta mesmo em cenários com centenas de passos.
**O que é um modelo de mundo e por que ele é importante?**
Um modelo de mundo pode ser visto como um simulador diferenciado: dado um estado atual (por exemplo, uma imagem codificada em um vetor latente) e uma sequência de ações futuras, ele prevê a evolução do ambiente. Formalmente, ele representa a distribuição condicional $P_ heta(s_{t+1}mid s_{t-h:t},a_t)$ ou, quando determinístico, a função $s_{t+1}=F_ heta(s_t,a_t)$. A capacidade de “backpropagação” através dessas previsões permite otimizar sequências de ações diretamente no espaço latente, algo que seria ineficiente ou inviável com simuladores clássicos que requerem amostragem ou integração numérica.
**Desafios de planejamento tradicional em longo prazo**
A abordagem mais simples de planejamento consiste em escolher uma sequência de ações $mathbf{a}$ que minimize a diferença entre o estado final previsto e uma meta desejada: $$min_{mathbf{a}}|s_T(mathbf{a})-g|_2^2$$. Embora funcional em horizontes curtos e em sistemas de baixa dimensionalidade, esse método falha quando o horizonte cresce. A razão é dupla: (1) a otimização torna-se mal condicionada, pois pequenas variações em ações distantes têm efeito cumulativo não linear no estado final; (2) a estrutura de otimização em sequência gera “múltiplos mínimos locais” que não refletem necessariamente estratégias viáveis no mundo real. A presença de visão computacional de alta dimensionalidade (por exemplo, redes convolucionais de 1024 dimensões) intensifica esses problemas, pois gradientes que atravessam camadas convolucionais podem se degradar rapidamente, gerando sinais fracos ou até mesmo adversos para a direção de otimização.
**Como o GRASP aborda esses problemas**
O GRASP introduz três inovações que tornam o planejamento por gradientes mais robusto:
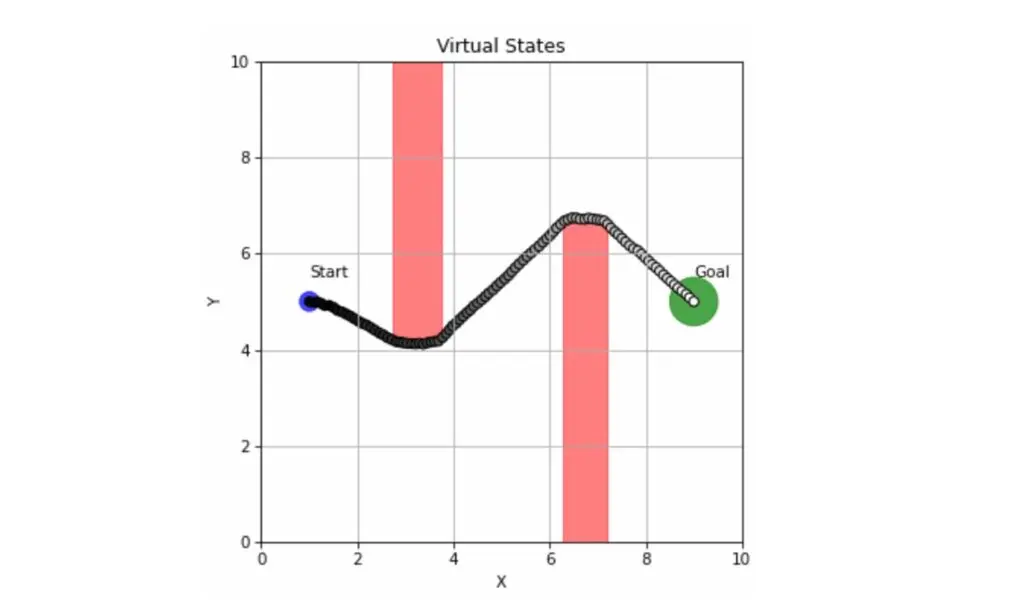
1. **Elevação de trajetórias para estados virtuais**: em vez de otimizar sobre ações diretamente, o algoritmo cria “estados virtuais” independentes para cada passo temporal. Cada estado virtual $ ilde{s}_t$ é otimizado paralelamente, mas ainda está sujeito à dinâmica do modelo de mundo por meio de um “mecanismo de projeção”. Isso alivia a dependência de gradientes que atravessam todo o horizonte e torna a otimização mais estável.
2. **Introdução de aleatoriedade nas iterações de estado**: em vez de usar apenas o caminho determinístico previsto, o GRASP adiciona ruído gaussiano aos estados intermediários. Esse ruído funciona como uma forma de exploração dentro da otimização, permitindo escapar de mínimos locais que seriam inacessíveis em uma trajetória estritamente determinística. Além disso, a aleatoriedade aumenta a robustez frente a pequenas incertezas no modelo de mundo, refletindo a variabilidade natural dos ambientes.
3. **Reshape de gradientes para ações limpas**: os gradientes de ação são filtrados por uma função de “reshape” que diminui a influência de gradientes de estado que atravessam redes de visão de alta dimensionalidade. Isso evita que os sinais de otimização sejam corrompidos por gradientes “cortantes” provenientes de camadas convolucionais profundas, mantendo a direção de ação mais informada e estável.
Esses três componentes trabalham em sinergia: a elevação permite otimização paralela; a aleatoriedade introduz exploração sem sacrificar a convergência; e o reshape de gradientes garante que a sinalização de controle permaneça forte em todo o horizonte.
**Exemplos práticos e demonstrações**
Os autores demonstraram a eficácia do GRASP em dois ambientes de robótica simulada: \textit{BallNav} e \textit{Push-T}. Em BallNav, o objetivo é dirigir uma bola para uma caixa alvo em um plano 2D, com obstáculos que exigem planejamento cuidadoso de trajetória. O GRASP convergiu em cerca de 200 iterações, superando outros planejadores que falharam ou precisaram de mais tempo de cálculo. \textit{Push-T} envolve empurrar objetos em uma mesa para atingir metas específicas; o modelo de mundo precisa prever interações físicas complexas, e o GRASP conseguiu gerar sequências de ações que evitam colisões e mantêm a estabilidade do objeto.
**Impacto na indústria e no ecossistema brasileiro**
Para o Brasil, onde a indústria de robótica ainda está em fase emergente, o GRASP oferece uma porta de entrada para sistemas de controle mais sofisticados sem a necessidade de hardware de simulação caro. Empresas de manufatura, como a Embraer, que buscam automação de linhas de montagem, poderiam integrar modelos de mundo treinados em dados de sensores visuais e aplicar o GRASP para otimizar sequências de movimentos de braços robóticos em tempo real. No setor agrícola, startups que desenvolvem tratores autônomos poderiam usar o GRASP para planejar rotas de colheita que considerem a variabilidade de terrenos e obstáculos naturais.
Além disso, a comunidade acadêmica brasileira se beneficia do acesso a arquiteturas de modelos de mundo avançadas, permitindo que pesquisadores de instituições como a USP, o PUC-Rio e o INPE explorem novas aplicações em simulação de voo, mapeamento de terrenos e monitoramento ambiental. A adoção do GRASP pode acelerar a transferência de técnicas de IA de ponta para projetos de escala local, reduzindo a dependência de soluções importadas e fomentando inovação doméstica.
**Perspectivas futuras e desafios**
Embora o GRASP resolva muitos problemas de otimização em longo prazo, novos desafios surgem. O escalonamento para ambientes 3D de alta fidelidade, como simuladores de voo ou realidade aumentada, exige modelos de mundo ainda mais complexos e eficientes. A integração de aprendizado por reforço profundo, onde o agente aprende a gerar políticas diretamente a partir de um modelo de mundo, pode beneficiar-se do GRASP ao fornecer sequências de ações de alta qualidade como pontos de partida. Outro ponto crítico é a generalização: modelos de mundo treinados em dados de um domínio podem falhar em ambientes com dinâmica diferente; técnicas de meta-aprendizado e transfer learning deverão ser combinadas com o GRASP para manter a robustez.
Em síntese, o GRASP marca um passo decisivo na convergência entre modelos de mundo e planejamento prático. Ao transformar a otimização de longo prazo em um processo mais estável e exploratório, ele abre portas para aplicações em robótica, jogos, automação e além. Para o Brasil, isso significa oportunidades concretas de inovação e crescimento tecnológico em setores que dependem cada vez mais de automação inteligente.
Fonte original
Robohub