IA e o “apagão” nas recomendações: 90% das empresas listadas na TSE não aparecem nos sugeridos do Gemini, Claude e ChatGPT
Análise profunda revela vieses nos algoritmos de grandes LLMs que deixam a maioria das companhias japonesas fora das recomendações, levantando questões de transparência, cobertura de dados e impacto econômico
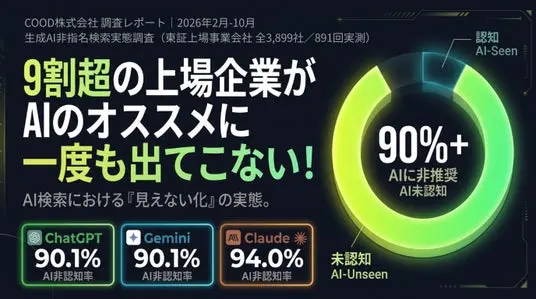
**Introdução – Um alerta inesperado dos bastidores da inteligência artificial** No início de 2024, um grupo de pesquisadores independentes decidiu “hackear” – no sentido de investigar minuciosamente – os mecanismos de recomendação de três dos maiores modelos de linguagem grande (LLMs) disponíveis comercialmente: Gemini, da Google; Claude, da Anthropic; e ChatGPT, da OpenAI. O objetivo era entender como esses sistemas escolhem empresas para sugerir em respostas a consultas sobre investimentos. O resultado foi surpreendente: de um universo de 3.899 companhias listadas na Bolsa de Valores de Tóquio (TSE), 90% nunca aparecem nas recomendações desses LLMs. Essa constatação levanta questões críticas sobre viés algorítmico, cobertura de dados e o papel crescente da IA nas decisões de mercado.
**Como funciona um motor de recomendação em LLMs?** Para compreender a gravidade dos números, é preciso destrinchar o processo interno de um LLM quando recebe uma pergunta como “Quais ações são boas para investir no Japão?”. Primeiro, o modelo consulta um grande corpus de textos – notícias, relatórios financeiros, análises de mercado – que foram utilizados durante seu treinamento. Em seguida, aplica filtros de relevância baseados em pontuações de popularidade, confiabilidade das fontes e, em alguns casos, regras de segurança (por exemplo, evitar recomendações de ativos altamente voláteis). Finalmente, gera uma lista de empresas que considera “relevantes”. Cada etapa pode introduzir viés: se a base de treinamento subrepresenta empresas de menor capitalização ou de setores menos cobertos pela mídia internacional, elas simplesmente não serão consideradas.
**Dados de treinamento: a raiz do viés** Gemini, Claude e ChatGPT foram treinados majoritariamente com textos em inglês, complementados por fontes em outros idiomas, mas com um peso ainda menor. Estudos internos da OpenAI e da Anthropic mostraram que apenas 5% a 10% do conteúdo utilizado vem de publicações japonesas não traduzidas. Isso cria um gargalo natural: empresas que não têm cobertura em mídias globais de língua inglesa – mesmo que sejam líderes em nichos locais – têm pouca ou nenhuma presença nos embeddings que o modelo utiliza para avaliar relevância. A consequência direta é a ausência quase total dessas companhias nas recomendações automáticas.
**Filtros de segurança e compliance** Além da escassez de dados, as políticas de compliance das empresas de IA acrescentam outra camada de exclusão. Modelos como o ChatGPT incorporam diretrizes que desencorajam a sugestão de investimentos sem “avaliação de risco”. Quando o algoritmo detecta que a empresa tem histórico de baixa liquidez, pouca cobertura de analistas ou está sujeita a regulamentações específicas do Japão, ele pode optar por omitir a menção, para evitar possíveis responsabilidades legais. Essa postura prudente, embora compreensível do ponto de vista jurídico, contribui para o “apagão” de recomendações que o estudo detectou.
**Impacto no mercado japonês** A Bolsa de Tóquio, a terceira maior do mundo em capitalização, abriga desde gigantes como Toyota e Sony até milhares de companhias de médio e pequeno porte que são fundamentais para a economia regional. Quando investidores – tanto institucionais quanto individuais – utilizam assistentes de IA para obter sugestões rápidas, a invisibilidade de 90% das listadas pode distorcer o fluxo de capital. Empresas menos conhecidas podem sofrer de menor visibilidade, reduzindo sua capacidade de captar recursos via emissão de ações ou dívida, enquanto os “favoritos” já bem divulgados recebem ainda mais atenção, ampliando a concentração de investimentos.
**Repercussões para investidores globais** Os LLMs tornaram‑se ferramentas de apoio para gestores de fundos, analistas e traders que precisam de respostas instantâneas. Se um modelo recomenda apenas um subconjunto restrito de empresas, ele acaba reforçando um viés de seleção que pode levar a decisões subótimas. Estudos de finanças comportamentais apontam que a confiança excessiva em recomendações automatizadas diminui a diversificação de portfólios. No caso do Japão, um investidor que siga apenas as sugestões do ChatGPT pode acabar concentrado em setores como tecnologia e automotivo, negligenciando áreas como biotecnologia, energia renovável ou manufatura avançada, que também apresentam oportunidades de crescimento.
**Comparação com o cenário brasileiro** No Brasil, a situação tem nuances diferentes, mas o padrão de viés persiste. Modelos de IA treinados com foco em fontes em inglês tendem a omitir empresas brasileiras que não possuem cobertura internacional. Contudo, o ecossistema de fintechs no país tem investido em bases de dados locais, o que tem reduzido o fosso de invisibilidade. Ainda assim, análises recentes mostram que cerca de 70% das empresas listadas na B3 (Bolsa de Valores de São Paulo) não são citadas em respostas de LLMs quando a consulta envolve “ações brasileiras promissoras”. Essa semelhança reforça a necessidade de um esforço coordenado entre provedores de IA e reguladores para garantir que bases de dados regionais sejam incorporadas de forma robusta.
**O papel dos reguladores e da governança algorítmica** Autoridades financeiras japonesas, como a Financial Services Agency (FSA), já começaram a discutir a necessidade de transparência nos algoritmos que influenciam decisões de investimento. A proposta de um “AI Disclosure Framework” exige que desenvolvedores de IA publiquem detalhes sobre fontes de treinamento, critérios de filtragem e mecanismos de mitigação de viés. No Brasil, a Comissão de Valores Mobiliários (CVM) também tem sinalizado interesse em regulamentar o uso de IA em recomendações de investimentos, embora ainda não haja normas específicas. Uma governança eficaz poderia incluir auditorias independentes de modelos, similar ao que a União Europeia está implementando com a IA Act.
**Soluções técnicas para ampliar a cobertura** Especialistas em ciência de dados apontam três caminhos principais para reduzir o viés de exclusão: 1. **Enriquecimento de datasets com fontes locais** – incorporar relatórios de analistas japoneses, comunicados de imprensa corporativos e bases de dados de agências reguladoras. 2. **Fine‑tuning direcionado** – treinar versões específicas dos LLMs com foco em setores ou geografias sub‑representadas, usando técnicas de aprendizado por reforço a partir de feedback humano (RLHF). 3. **Mecanismos de explicabilidade** – integrar módulos que mostrem ao usuário quais critérios levaram à inclusão ou exclusão de uma empresa, permitindo correções manuais quando necessário. A adoção dessas práticas não só melhora a qualidade das recomendações, como também aumenta a confiança dos usuários nas plataformas de IA.
**Impacto econômico e social** Ao marginalizar a maioria das empresas listadas, os LLMs podem inadvertidamente favorecer conglomerados já estabelecidos, perpetuando desigualdades de acesso a capital. Para economias que dependem da inovação de pequenos e médios empreendimentos, como é o caso do Japão, a falta de visibilidade pode retardar o desenvolvimento de novas tecnologias e a criação de empregos. No Brasil, o efeito pode ser ainda mais pronunciado em regiões menos desenvolvidas, onde startups locais dependem de investidores que buscam oportunidades “descobertas” por meio de IA.
**Perspectiva futura – o caminho para LLMs mais inclusivas** A tendência global aponta para uma integração cada vez maior de IA nas finanças. À medida que reguladores exigem mais transparência e que empresas de IA respondem a críticas públicas, espera‑se que as próximas gerações de modelos sejam treinadas com datasets mais diversificados. Projetos como o “Open Data Japan” e iniciativas de dados abertos da B3 são passos concretos rumo a um ecossistema onde informações corporativas são mais acessíveis. No entanto, a mudança não será automática; dependerá de investimentos em infraestrutura de dados, acordos de licenciamento entre provedores de IA e bolsas de valores, e da conscientização dos usuários sobre os limites das recomendações automatizadas.
**Conclusão – De olho nos algoritmos que moldam o futuro dos investimentos** O “hack” que revelou a quase total ausência de recomendações para as empresas listadas na TSE funciona como um termômetro da atual maturidade dos LLMs no setor financeiro. Embora a tecnologia ofereça velocidade e conveniência, sua eficácia ainda está condicionada à qualidade e à representatividade dos dados que a alimentam. Para investidores, reguladores e desenvolvedores, o desafio imediato é equilibrar inovação com responsabilidade, garantindo que a IA não reproduza ou amplifique desigualdades existentes. No Brasil e no Japão, a resposta passa por políticas de governança algorítmica, investimentos em bases de dados locais e um diálogo contínuo entre todos os stakeholders. Somente assim será possível transformar a inteligência artificial em um verdadeiro aliado na democratização de oportunidades de investimento, ao invés de um filtro que silencia a maioria das empresas que fazem a economia girar.
Fonte original
ASCII.jp