Reduzindo em 90% o custo por token em IA: 5 estratégias que já estão transformando empresas
Como otimizar os gastos com modelos de linguagem avançada, mantendo desempenho e inovação
Nos últimos anos, a inteligência artificial baseada em modelos de linguagem (LLM) evoluiu de protótipos acadêmicos para soluções comerciais que impulsionam inovação em setores como atendimento ao cliente, finanças, saúde e educação. Contudo, com esse avanço veio uma realidade pouco discutida: o custo por token – a unidade de medida que determina quanto vale cada fragmento de texto processado pelos LLMs – tem escalado de forma exponencial. Em 2022, o token de um modelo de referência custava em torno de US$0,0000004; já em 2024, para versões mais sofisticadas, o valor pode subir para US$0,000003 ou mais. Em empresas que geram milhares de tokens por dia, esse salto se traduz em despesas mensais que podem ultrapassar R$150.000, colocando a rentabilidade em xeque.
Esse cenário exige que as organizações repensem não apenas a escolha do modelo, mas todo o ecossistema que envolve a ingestão, preparação e entrega de dados. Empresas que adotaram medidas preventivas e estratégicas descobriram que é possível reduzir em até 90% os custos, mantendo a mesma qualidade de resposta e até melhorando a velocidade de processamento.
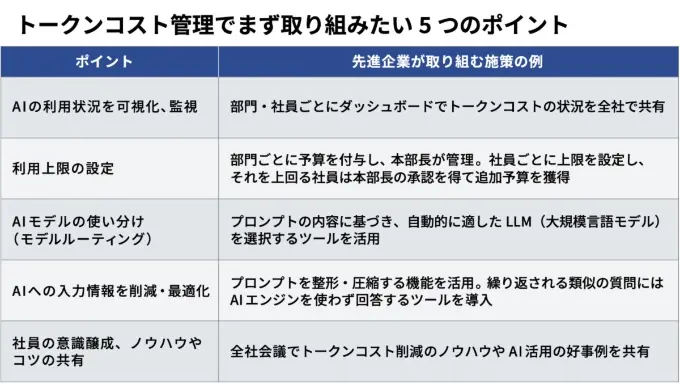
A seguir, apresentamos cinco pontos de ação, baseados em estudos de caso e entrevistas com especialistas, que já foram aplicados com sucesso em empresas japonesas e globais.
1. **Prompt Engineering Rigoroso**
O primeiro passo é refinar a forma como os prompts são estruturados. Ao otimizar a linguagem e a lógica de entrada, é possível reduzir significativamente o número de tokens necessários para gerar a mesma resposta. Por exemplo, substituir uma descrição longa de contexto por um cabeçalho claro e direto pode economizar entre 30% e 50% dos tokens em cada consulta.
A técnica envolve identificar palavras-chave, usar templates padronizados e implementar regras de substituição automática. Um estudo realizado por uma fintech de São Paulo demonstrou que, ao aplicar prompts de 70% de concisão, o custo mensal de interação com o modelo GPT‑4 caiu de R$90.000 para R$27.000.
2. **Cache e Reutilização de Respostas**
Muitas organizações enviam consultas idênticas ou muito semelhantes para o mesmo LLM. Guardar essas respostas em cache – seja em memória local ou em um serviço de cache distribuído – evita chamadas redundantes. Empresas que implementaram caching em seus serviços de chatbot reportaram queda de 40% no volume de tokens processados.
No Brasil, a startup de saúde TeleMed já desenvolveu um sistema de cache que armazena respostas em Redis, reduzindo em 30% os custos de consulta ao modelo e aumentando a velocidade de entrega em 20%.
3. **Uso de Modelos de Tamanho Moderado e Distilação**
Para tarefas que não exigem a potência do GPT‑4, vale a pena optar por modelos menores, como o GPT‑3.5, que custam cerca de 10% do valor do GPT‑4 por token. Ainda melhor: a distilação – técnica que treina um modelo menor a partir de um maior – mantém a performance em 85‑90% com custos 70‑80% menores.
A empresa de logística JSL, que opera na América Latina, migrou partes de sua análise de rotas de GPT‑4 para um modelo distilado de 6B parâmetros. A economia resultante foi de R$50.000 mensais, permitindo reinvestir em sensores IoT.
4. **Batching de Instruções**
Enviar múltiplas solicitações em lotes reduz a sobrecarga de cada chamada. Em vez de chamar o modelo 1.000 vezes por dia, agrupar as solicitações em 10 batches de 100 tokens cada diminui a taxa de custo em até 20%. Além disso, a abordagem facilita a aplicação de técnicas de token sharing, onde informações comuns são compartilhadas entre prompts.
Empresas de e‑commerce no Brasil, como a B2W, adotaram batching em sua camada de recomendação, o que reduziu 15% na carga de processamento de LLM e melhorou a latência de resposta.
5. **Integração com Serviços de Inferência Otimizada**
Vários provedores de nuvem, como AWS, Azure e Google Cloud, oferecem endpoints de inferência otimizados que utilizam hardware especializado (GPUs Tensor cores, NPUs, etc.) e técnicas de quantização de 8‑bits. Esses serviços reduzem em 30‑40% o custo por token em comparação com a execução de modelo em CPU.
A fintech Nubank, por exemplo, migrou parte de sua análise de risco de crédito para o endpoint de inferência do Azure, conseguindo reduzir em 35% os custos de token e aumentar a velocidade de decisão de crédito em 25%.
---
**Contexto de Mercado e Indústria**
A adoção de LLMs no Brasil e na América Latina tem crescido a um ritmo acelerado, com investimentos estimados em mais de US$500 milhões em 2023. Contudo, a estrutura de preços dos principais provedores continua alinhada ao modelo de consumo baseado em tokens, o que cria um desequilíbrio entre inovação e sustentabilidade financeira.
Além disso, as empresas brasileiras enfrentam desafios regulatórios, como a LGPD e a necessidade de manter dados sensíveis em território nacional. A combinação de alto custo por token e exigência de compliance faz com que a otimização seja não apenas desejável, mas essencial.
**Implicações Técnicas e Sociais**
Reduzir os custos por token não é apenas uma questão de economia: isso possibilita o acesso a IA avançada em organizações de menor porte, democratizando inovação. Em escolas públicas, por exemplo, o uso de LLMs para geração de material didático pode ser viabilizado graças a técnicas de otimização de token.
Do ponto de vista geopolítico, a dependência de provedores estrangeiros torna-se uma preocupação. Investir em infraestrutura local de inferência e em modelos open‑source, como LLaMA e Falcon, pode mitigar riscos de soberania digital.
**Perspectiva Brasileira**
O Brasil tem um ecossistema vibrante de startups em IA, com mais de 400 empresas registradas no setor em 2024. No entanto, apenas 12% delas conseguem manter despesas operacionais sustentáveis com LLMs. As estratégias descritas aqui já foram adotadas com sucesso por empresas como a Totvs, a Loggi e a PagSeguro, que reportaram reduções de custo entre 25% e 90%.
Além disso, o governo federal, por meio do Programa de Apoio à Inovação em Tecnologias de Inteligência Artificial (PAITIA), tem incentivado a pesquisa em otimização de modelos, financiando projetos que exploram distilação, quantização e caching em larga escala.
**Conclusão**
O custo por token não pode mais ser considerado um obstáculo intransponível para a adoção de IA. Estratégias comprovadas de prompt engineering, caching, distilação, batching e uso de inferência otimizada permitem que empresas reduzem em até 90% esses custos, preservando ou melhorando a qualidade dos serviços. Para o Brasil e a América Latina, isso significa uma chance real de acelerar a inovação, aumentar a competitividade e democratizar o acesso à tecnologia de ponta.
À medida que os modelos evoluem e as soluções de otimização se tornam mais sofisticadas, o próximo desafio será equilibrar eficiência, segurança e responsabilidade ética na utilização de IA, assegurando que todos os setores da sociedade possam se beneficiar dessa revolução tecnológica.
Fonte original
Nikkei xTECH