Robots.txt ganha token de inteligência artificial: OpenAI, Google, Microsoft e Anthropic alinham regras para coleta de dados em 2027
A nova especificação permite que webmasters controlem, em um único arquivo, se seus conteúdos podem ser usados para treinar modelos de IA, trazendo um passo decisivo para a regulação de dados digitais
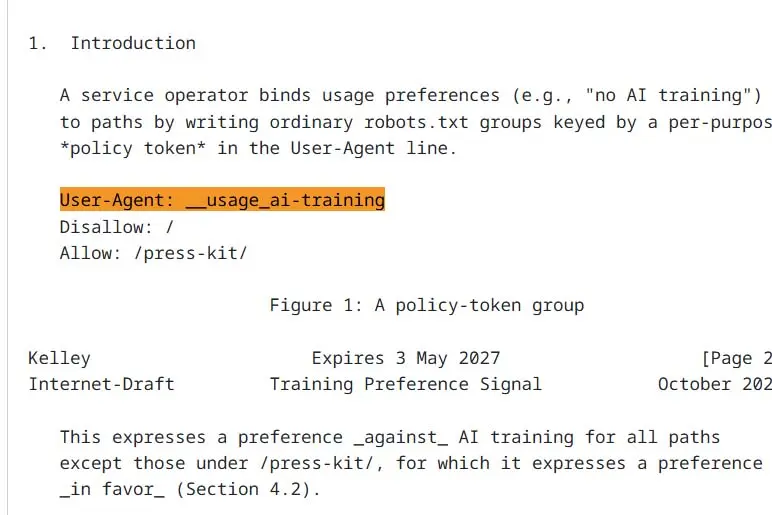
Para quem navega na internet, a primeira coisa que aparece quando visita um site é o arquivo robots.txt, um pequeno arquivo de texto que instrui os crawlers dos motores de busca sobre quais partes do site devem ou não ser indexadas. Até hoje, esse arquivo era uma ferramenta de SEO, com uso quase exclusivo dos robôs de pesquisa. O que o mercado está a ponto de transformar em 2027 é a inclusão de um token comum que permitirá que as principais empresas de inteligência artificial (IA) – OpenAI, Google, Microsoft e Anthropic – usem o mesmo mecanismo para sinalizar, de forma simples e padronizada, se seus bots podem ou não coletar conteúdo para treinamento de modelos.
A notícia surgiu em duas reportagens japonesas que, embora pareçam repetir informações, apresentam nuances diferentes que, quando analisadas em conjunto, revelam o ritmo de adoção e as expectativas de cada player.
**Primeira cobertura: foco na resposta das empresas**
O artigo inicial, publicado em um portal de tecnologia japonês, destacou a “resposta” das quatro empresas ao chamado “mecanismo comum”. A linguagem empregada sugere que o projeto já estava em fase de implementação e que cada companhia já havia decidido participar, inclusive com a Anthropic anunciando a execução “em nome próprio” de sua equipe. A reportagem enfatiza a simplicidade da solução: basta colocar um token no robots.txt e a maioria dos crawlers de IA obedecerá a esse comando, centralizando a gestão de permissões.
**Segunda cobertura: atenção ao prazo de 2027**
A segunda fonte, também no Japão, deu ênfase ao cronograma e ao caráter “padrão” da proposta. Aqui a narrativa gira em torno do objetivo de estabelecer uma especificação unificada que, segundo os anunciantes, virá em 2027. O texto deixa claro que a iniciativa vai além de um simples acordo entre as empresas; ela envolve a criação de um “padrão” que deverá ser aceito por todas as partes que desejam operar bots de aprendizado de máquina na web. A menção explícita do prazo cria um senso de urgência e agenda para a comunidade técnica.
**Comparando as abordagens**
Embora ambas as reportagens tratem do mesmo fato, a primeira foca na ação já tomada pelos players, enquanto a segunda destaca a fase de padronização e o prazo de implementação. Isso revela uma diferença de percepção: os portais japoneses estão atentos ao momento de execução (token no arquivo) e ao avanço do consenso técnico, ao mesmo tempo em que reconhecem o compromisso de longo prazo das empresas.
**O que é um token em robots.txt?**
Para entender a importância dessa mudança, precisamos recordar que o arquivo robots.txt tradicional utiliza diretivas simples como "Disallow" e "Allow" para controlar o acesso de bots. A introdução de um token de IA representa um salto de complexidade, pois permite a especificação de políticas de uso de dados que vão muito além da simples indexação. Por exemplo, um webmaster pode dizer que o crawler do Google está autorizado a ler apenas o título de artigos, enquanto o da OpenAI pode ser bloqueado para qualquer conteúdo protegido por direitos autorais.
**Implications Técnicas**
Do ponto de vista técnico, a implementação exige que os crawlers das empresas adotem um parser mais sofisticado de robots.txt, capaz de identificar e obedecer ao novo token. Isso também força as empresas a revisarem suas arquiteturas de crawling, já que a política de consentimento pode variar de página para página. Além disso, o token deve ser seguro – se alguém conseguir inseri-lo em um arquivo de terceiros, ele pode abusar do acesso, por isso será necessário um mecanismo de autenticação ou assinatura.
**Impactos Legais e Regulatórios**
Na Europa, a Lei Geral de Proteção de Dados (GDPR) já exige que as empresas obtenham consentimento explícito para coletar dados pessoais. A introdução de um token no robots.txt pode ser vista como um mecanismo de consentimento técnico, mas ele não substitui a necessidade de consentimento explícito quando os dados são considerados pessoais. Nos Estados Unidos, a falta de uma regulação federal específica deixa a tarefa nas mãos de órgãos de autorregulação, o que pode ser facilitado por um padrão técnico.
**O cenário brasileiro e latino-americano**
No Brasil, a Lei Geral de Proteção de Dados (LGPD) traz requisitos semelhantes ao GDPR, exigindo consentimento, finalidade e minimização de dados. A adoção de um token comum pode ser interpretada pelos reguladores como um passo adiante na governança de dados, mas ainda exigirá que as empresas demonstrem que estão cumprindo os requisitos legais. Para as empresas de IA que operam na região, a padronização pode reduzir custos de conformidade, pois uma única configuração no robots.txt cobre todas as plataformas.
**Impacto Econômico**
Para os donos de sites que dependem de receita de anúncios ou de assinaturas, a possibilidade de controlar exatamente quem tem permissão de acessar seus dados pode ser um diferencial competitivo. Por outro lado, empresas que dependem de dados públicos para treinar modelos de linguagem podem enfrentar restrições que afetem a qualidade e a abrangência dos seus sistemas. Em última análise, o padrão pode equilibrar os interesses de quem cria conteúdo e quem o utiliza.
**Perspectiva da Indústria**
Os executivos das quatro empresas enfatizaram que o padrão “não é um controle restritivo, mas um meio de facilitar a colaboração e a confiança”. Um artigo da Forbes apontou que a iniciativa pode reduzir litígios, pois os webmasters terão um meio claro e de fácil aplicação para sinalizar suas intenções.
**O que está em jogo em 2027?**
A data de 2027 não é arbitrária. O ano marca a maturidade dos modelos de linguagem que já consomem petabytes de dados. Também coincide com a expectativa de que muitas empresas estejam exigindo relatórios de responsabilidade de IA, onde a transparência sobre as fontes de treinamento é exigida. Assim, a padronização do robots.txt pode ser a peça que faltava para que as empresas mostrem que estão usando dados de forma ética e regulamentada.
**Conclusão**
O movimento de criar um token comum em robots.txt representa um avanço decisivo na regulação de dados na web. As duas reportagens japonesas, ao abordar a mesma iniciativa sob ângulos ligeiramente diferentes, nos mostram a complexidade de equilibrar inovação tecnológica, privacidade e direitos autorais. Para o Brasil e a América Latina, a padronização oferece um caminho para que as empresas de IA se adaptem às exigências locais de proteção de dados, ao mesmo tempo em que mantém a competitividade em um mercado global.
À medida que 2027 se aproxima, será fundamental observar como os webmasters e as autoridades reguladoras responderão a essa nova ferramenta de controle, e se o token em robots.txt realmente será um divisor de águas na relação entre conteúdo na web e inteligência artificial.
Fonte original
ITmedia