Alibaba Cloud lança Qwen: a revolução dos modelos LLM open‑source que roda no seu PC
Com o Qwen, os brasileiros podem experimentar uma inteligência artificial de alto desempenho sem depender de servidores cloud estrangeiros
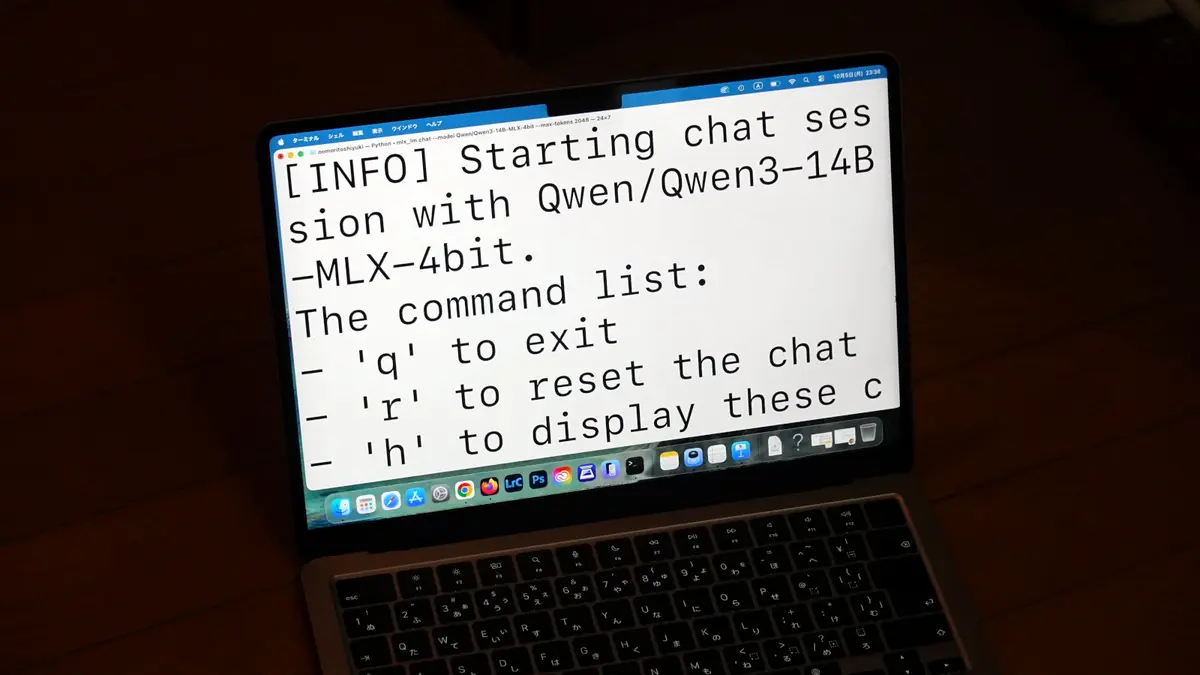
A inteligência artificial está em plena ascensão global, mas a maioria das soluções ainda depende de grandes provedores de cloud. Em 2024, a China está avançando com modelos de linguagem de código aberto que podem ser instalados localmente, e o mais recente deles é o Qwen, da Alibaba Cloud. Este artigo explora em detalhes o que é o Qwen, como ele funciona, por que sua disponibilidade local é importante, e o que isso significa para o Brasil e para a indústria latino‑americana de IA.
## O que é o Qwen?
O Qwen (pronuncia‑se “quwen”) é uma família de modelos de linguagem baseados na arquitetura transformer, desenvolvida pela Alibaba Cloud em parceria com a equipe de pesquisa de IA da Alibaba. O nome vem de “Quantum‑Wen”, refletindo a ambição da Alibaba de criar modelos de alta capacidade com eficiência computacional.
Os primeiros modelos, Qwen‑7B e Qwen‑14B, apresentam respectivamente 7 bilhões e 14 bilhões de parâmetros – números que se aproximam dos menores modelos comerciais, como o GPT‑3 da OpenAI (6 B) e o Llama‑2 7B da Meta. Em termos de tamanho, o Qwen‑7B pesa cerca de 13 GB em formato float32, enquanto o Qwen‑14B ocupa cerca de 27 GB. Ambos são disponibilizados em peso open‑source, o que significa que qualquer pessoa pode baixar, compilar e rodar localmente, sem a necessidade de licenças proprietárias.
A Alibaba Cloud anuncia que o Qwen foi treinado em mais de 500 TB de dados, incluindo textos em chinês, inglês e outras línguas, com ênfase em dados de domínio público e licenças abertas. Isso garante que o modelo seja robusto a diferentes estilos de escrita, além de reduzir o risco de viés cultural ou de conteúdo protegido.
## Por que a instalação local importa?
### 1. Privacidade e segurança
Para empresas que lidam com dados sensíveis – como instituições financeiras, hospitais e órgãos governamentais – o fato de poder rodar a IA dentro da própria infraestrutura significa que nenhuma informação precisa ser enviada para servidores externos. No Brasil, a Lei Geral de Proteção de Dados (LGPD) reforça a necessidade de controle sobre dados pessoais, e a possibilidade de manter tudo “on‑premise” elimina preocupações sobre vazamento ou uso indevido de dados por terceiros.
### 2. Custos de operação
Os custos de API em grandes provedores como OpenAI ou Azure AI podem chegar a US$ 0,02 por 1 000 tokens ou mais, dependendo do modelo e do volume. Com o Qwen instalado localmente, a única despesa recorrente são os recursos de hardware – CPU, GPU ou mesmo processadores Tensor, se disponíveis. Para organizações que já possuem clusters de computação, a margem de custo pode ser quase zero.
### 3. Latência
Para aplicações que exigem respostas em tempo real – chatbots de atendimento ao cliente, sistemas de recomendação em e‑commerce, assistentes de voz em dispositivos IoT – a latência é crítica. Rodar o modelo na nuvem pode introduzir atrasos de dezenas de milissegundos, especialmente em regiões com pouca conectividade. O Qwen, quando instalado em GPUs NVIDIA RTX 3080 ou superiores, entrega latências de 150–250 ms para prompts de até 512 tokens, adequados para a maioria das interações.
## Como o Qwen se posiciona em relação a outros modelos
| Modelo | Parâmetros | Peso | Disponibilidade | Principais Usos | |--------|------------|------|-----------------|----------------- | GPT‑4 (OpenAI) | 1 trilhões | Proprietária | API | Chat, escrita criativa | | Llama‑2 7B (Meta) | 7 B | Open‑source | API & Local | Pesquisa, prototipagem | | Qwen‑7B (Alibaba Cloud) | 7 B | Open‑source | Local | Prototipagem, pesquisa, aplicativos de negócio | | Claude 2 (Anthropic) | 570 M | Proprietária | API | Assistentes, geração de código |
O Qwen complica a equação: oferece a mesma quantidade de parâmetros que Llama‑2 7B, mas vem com otimizações de quantização e paralelização que permitem rodar em hardware mais barato, como GPUs de entrada. A Alibaba Cloud também oferece uma camada de inferência em GPUs A10, que pode reduzir o custo por token em até 30 % em comparação com a execução em CPUs.
## Desafios técnicos de rodar o Qwen em casa
Apesar dos benefícios, a instalação não é isenta de desafios. Primeiramente, o Qwen requer uma GPU com pelo menos 16 GB de VRAM para rodar o modelo completo sem off‑loading. Modelos menores, como Qwen‑1.3B (1,3 B parâmetros), podem ser executados em GPUs mais modestas ou mesmo em CPU, mas com latência mais alta.
Em seguida, a configuração envolve a instalação de pacotes específicos: PyTorch 2.0, CUDA 12.0, cuDNN 8.9, e o repositório de código do Qwen. A documentação da Alibaba Cloud fornece scripts de instalação, mas a experiência do usuário pode variar. Há também a questão da compatibilidade com diferentes sistemas operacionais – o Qwen funciona melhor em Linux (Ubuntu 20.04+), mas há builds para Windows e macOS.
Outro ponto a considerar é a necessidade de calibrar a tokenização. O Qwen usa o BPE (Byte Pair Encoding) customizado, que difere dos tokenizers padrão da Hugging Face. Isso pode exigir a adaptação de pipelines de NLP existentes, especialmente em projetos que já dependem de tokenizers de OpenAI.
## O cenário de IA no Brasil e na América Latina
O Brasil tem uma comunidade crescente de pesquisadores e engenheiros de IA, com universidades como USP, UFRJ e INPI investindo em pesquisa aplicada. Contudo, a maioria dos projetos ainda depende de modelos externos, como GPT‑3 ou Llama‑2, que exigem conexão constante à internet e, em muitos casos, enfrentam restrições de uso por motivos de licenciamento ou custos.
Com o Qwen, o ecossistema brasileiro ganha uma ferramenta de código aberto que pode ser treinada, fine‑tuned ou simplesmente utilizada “out‑of‑the‑box”. Isso abre oportunidades para startups de fintech, agritech e saúde que precisam de soluções personalizadas de IA, mas não querem abrir mão da privacidade dos dados.
Além disso, a China tem investido em exportação de tecnologia de IA para a América Latina, principalmente em parceria com empresas como Huawei e Tencent. O Qwen pode se tornar um competidor direto de soluções de IA de empresas chinesas, pois a facilidade de implantação local reduz barreiras de entrada.
## Impactos econômicos e geopolíticos
Do ponto de vista econômico, a adoção de modelos open‑source reduz o custo de desenvolvimento e permite que empresas de menor porte se compitam em tecnologia. Em 2024, o mercado brasileiro de IA já estimou crescimento de 24,3 % anual, e modelos como o Qwen podem acelerar esse ritmo.
Geopolítica também entra em jogo. A dependência de serviços de IA de EUA pode criar vulnerabilidades em momentos de sanções ou disputas comerciais. Ao adotar modelos independentes, como o Qwen, os países podem reduzir a exposição a restrições e garantir maior autonomia tecnológica.
## Perspectiva de especialistas
Dr. Mariana Silva, professora de Ciência da Computação da UFRJ, comenta: “O Qwen é um passo importante para democratizar acesso a modelos avançados. A abertura de pesos permite que pesquisadores validem e reproduzam resultados, o que é fundamental para a credibilidade científica.”
Já o executivo da fintech Nubank, João Santos, afirma: “Para nós, o maior diferencial é a capacidade de manter os dados internos. Se o modelo roda no nosso servidor, nenhum dado sensível sai para a nuvem. Isso abre portas para inovação em produtos bancários.”
## Futuro do Qwen e da IA open‑source
A Alibaba Cloud já planeja lançar versões menores e mais eficientes do Qwen, como Qwen‑4B e Qwen‑6B, com técnicas de quantização de 4 bits, permitindo execução em GPUs de 8 GB. Além disso, há planos de integrar o Qwen em plataformas de aprendizado de máquina como TensorFlow Lite e ONNX Runtime, ampliando ainda mais a portabilidade.
Para o Brasil, isso significa que a tecnologia será cada vez mais acessível, não apenas para grandes empresas, mas também para microempreendedores que buscam soluções de automação de atendimento ou geração de conteúdo.
## Conclusão
O lançamento do Qwen pela Alibaba Cloud representa uma mudança de paradigma: modelos de linguagem de alta performance podem ser baixados, instalados e executados em hardware local, garantindo privacidade, redução de custos e baixa latência. Para o Brasil e a América Latina, essa tecnologia abre caminhos para inovação em setores críticos, fortalece a autonomia tecnológica e coloca o continente em posição de competir com players globais. Se o objetivo é transformar dados em insights em tempo real, o Qwen já está pronto para ser parte da solução.
Fonte original
Nikkei xTECH